Engineering Hybrid RAG với MongoDB Atlas Vector Search và Voyage AI
Mẫu kỹ thuật này sử dụng MongoDB Atlas Vector Search cùng embedding Voyage AI và tùy chọn reranking để xây dựng Retrieval API có thể tái sử dụng cho workload tri thức doanh nghiệp.
Đã xuất bản 2 thg 10, 2026 · Cập nhật 2 thg 10, 2026
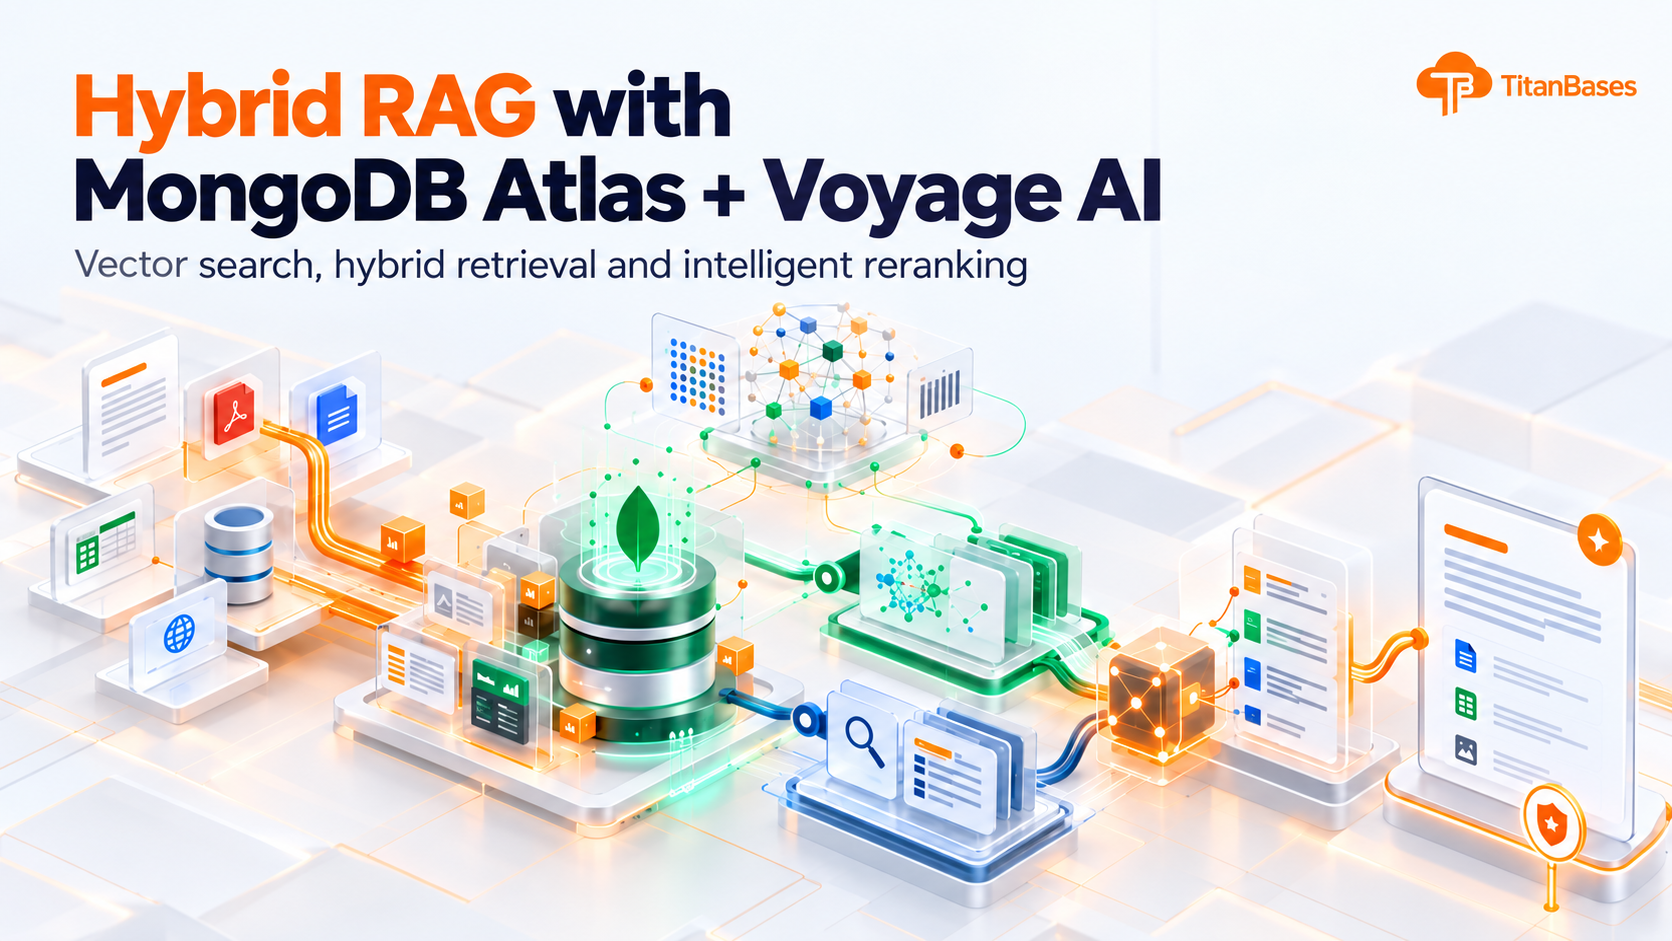
Hệ thống Retrieval-Augmented Generation (RAG) production cần nhiều hơn một vector database và một LLM. Lớp retrieval phải nạp nội dung doanh nghiệp luôn thay đổi, kết hợp tín hiệu ngữ nghĩa và từ khóa, áp dụng kiểm soát truy cập dựa trên metadata, đánh giá chất lượng retrieval và trả về context với độ trễ có thể dự đoán. Mẫu kỹ thuật này sử dụng MongoDB Atlas Vector Search cùng embedding Voyage AI và tùy chọn reranking để xây dựng Retrieval API có thể tái sử dụng cho workload tri thức doanh nghiệp.
Trong một pilot tham chiếu sử dụng hơn 100.000 chunks, Retrieval API duy trì độ trễ P95 dưới 1.5 giây, không bao gồm thời gian LLM tạo nội dung, trong khi Recall@5 đạt ít nhất 70% trên bộ đánh giá của pilot. Pipeline ingestion cũng hỗ trợ đồng bộ tăng dần dựa trên checksum và xử lý corpus pilot với tỷ lệ lỗi xử lý dưới 2%. Đây là các kết quả kỹ thuật đặc thù workload, không phải cam kết chung cho mọi sản phẩm.
1. Bài toán kỹ thuật: tri thức doanh nghiệp bị phân mảnh
Tri thức doanh nghiệp hiếm khi nằm trong một hệ thống duy nhất. Tài liệu có thể nằm trong object storage hoặc nền tảng cộng tác, còn context vận hành nằm trong các database ứng dụng. Vì vậy, triển khai RAG phải giải quyết hai bài toán liên kết: tạo một retrieval index tin cậy trên các nguồn không đồng nhất và cung cấp index đó qua một API được kiểm soát để ứng dụng và model ngôn ngữ có thể sử dụng nhất quán.
Lớp retrieval yếu có thể trả về context không đầy đủ hoặc không liên quan, bỏ qua ranh giới authorization hoặc yêu cầu re-index tốn kém mỗi khi dữ liệu nguồn thay đổi. Kiến trúc nên xem retrieval là một dịch vụ production độc lập thay vì một helper nhỏ bên trong chatbot.
2. Retrieval như lớp dữ liệu AI độc lập
Mẫu cốt lõi tách retrieval khỏi model ngôn ngữ downstream. MongoDB Atlas lưu chunks, metadata và embedding, đồng thời cung cấp vector-search index. Voyage AI cung cấp lớp embedding và có thể tùy chọn rerank các ứng viên hàng đầu. Sau đó, Retrieval API điều phối retrieval vector, tín hiệu từ khóa, bộ lọc metadata và quy tắc kiểm soát truy cập trước khi trả context về model.
| Lớp | Công nghệ / pattern | Vai trò engineering |
|---|---|---|
| Kho dữ liệu và vector | MongoDB Atlas | Lưu chunks, metadata và embedding; phục vụ các vector-search index. |
| Embedding | Voyage AI embeddings | Tạo vector ngữ nghĩa cho nội dung đa ngôn ngữ hoặc nội dung theo domain. |
| Reranking | Voyage AI Reranker (tùy chọn) | Sắp xếp lại các ứng viên hàng đầu khi workload hưởng lợi từ một bước đánh giá mức liên quan thứ hai. |
| Ingestion | Pipeline đồng bộ tăng dần | Trích xuất, chia chunk, tính checksum, loại trùng và cập nhật nội dung đã thay đổi. |
| Retrieval API | Pattern FastAPI / NestJS | Điều phối retrieval vector + keyword, bộ lọc metadata, kiểm tra ACL và định dạng response. |
3. Vì sao hybrid retrieval quan trọng
Retrieval ngữ nghĩa hữu ích khi người dùng diễn đạt khái niệm khác với văn bản nguồn, trong khi tín hiệu keyword vẫn có giá trị với identifier, tên sản phẩm, thuật ngữ policy và từ vựng cần khớp chính xác. Lớp hybrid retrieval cho phép ứng dụng kết hợp các tín hiệu này thay vì buộc mọi query đi qua một chế độ tìm kiếm duy nhất.
Retrieval API cũng là nơi phù hợp để chuẩn hóa bộ lọc và trả về một result contract nhất quán cho các ứng dụng downstream. Điều này giữ cho tích hợp model độc lập với chi tiết indexing và tuning retrieval.
4. Áp dụng ACL metadata trước khi context tới LLM
Authorization nên được thực thi trong quá trình retrieval, không phải sau khi context nhạy cảm đã được tập hợp. Trong mẫu này, các bộ lọc ACL dựa trên metadata được áp dụng trực tiếp trong luồng vector query để chỉ những chunk được phép mới được trả về cho việc xây dựng prompt hoặc context.
Điều này không thay thế mô hình identity và authorization của doanh nghiệp. Nó mở rộng các control đó vào lớp retrieval để quyền ứng dụng và việc chọn context RAG luôn đồng bộ.
5. Ingestion tăng dần thay vì re-index toàn bộ
Nguồn tri thức thay đổi liên tục. Vì vậy pipeline ingestion theo dõi version hoặc checksum của nguồn và chỉ cập nhật nội dung đã thay đổi. Extraction, chunking và deduplication được xem là các bước pipeline có thể lặp lại, còn item lỗi có thể retry hoặc chuyển tới dead-letter path để điều tra.
Pilot đã xử lý hơn 100.000 chunks với tỷ lệ lỗi xử lý dưới 2% và sử dụng đồng bộ tăng dần để tránh xây dựng lại toàn bộ corpus khi nội dung không thay đổi.
6. Đo retrieval tách biệt khỏi generation
Đánh giá RAG trở nên khó khăn khi độ trễ retrieval và độ trễ model generation bị trộn vào một con số. Pilot tham chiếu đo Retrieval API riêng: P95 duy trì dưới 1.5 giây cho workload pilot, không bao gồm thời gian language model tạo câu trả lời cuối.
Chất lượng retrieval được đánh giá bằng Recall@5 trên bộ câu hỏi đặc thù workload và đạt ít nhất 70%. Con số này mô tả việc tài liệu nguồn liên quan có được đưa vào top năm kết quả trên bộ đánh giá pilot hay không. Đây không phải thước đo độ đúng của câu trả lời cuối và không nên áp dụng cho corpus khác nếu chưa đánh giá lại.
| Tiêu chí pilot | Kết quả quan sát / chấp nhận | Diễn giải |
|---|---|---|
| Corpus | 100,000+ chunks | Quy mô pilot tham chiếu. |
| Độ trễ retrieval | P95 < 1.5 s | Chỉ Retrieval API; không gồm LLM generation. |
| Chất lượng retrieval | Recall@5 >= 70% | Bộ đánh giá pilot; đặc thù workload. |
| Độ tin cậy ingestion | Tỷ lệ lỗi xử lý < 2% | Pipeline gồm retry / xử lý dead-letter. |
| Đồng bộ dữ liệu | Đồng bộ tăng dần | Luồng cập nhật dựa trên checksum/version. |
7. Reranking nằm ở đâu
Reranking hữu ích khi retrieval giai đoạn đầu trả về một tập ứng viên vẫn cần model liên quan mạnh hơn. Voyage AI Reranker có thể được chèn sau bước retrieval ban đầu để sắp xếp lại các ứng viên hàng đầu trước khi tập hợp context. Vì reranking bổ sung thêm một bước network và compute, cần đánh giá nó theo yêu cầu độ trễ và mức liên quan thay vì tự động bật.
8. Các cân nhắc production ngoài pilot
- Xác định bộ đánh giá đại diện trước khi tuning retrieval.
- Đo độ trễ retrieval tách biệt khỏi độ trễ model generation.
- Theo dõi phiên bản chunking, embedding và index để các thử nghiệm có thể tái lập.
- Áp dụng bộ lọc authorization trước khi tập hợp context.
- Sử dụng ingestion tăng dần và khả năng quan sát vận hành cho nội dung lỗi hoặc cũ.
- Đánh giá liệu reranking có cải thiện mức liên quan đáng kể cho workload hay không.
- Xem các con số benchmark là đặc thù workload; kiểm thử lại khi quy mô corpus, bộ lọc, chiến lược embedding hoặc đường network thay đổi.
9. Các điểm chính
- Chất lượng RAG phụ thuộc vào hệ thống retrieval, không chỉ language model.
- MongoDB Atlas có thể kết hợp dữ liệu vận hành, metadata, embedding và vector retrieval trong một mẫu nền tảng dữ liệu.
- Một Retrieval API riêng tạo interface có thể tái sử dụng cho các LLM và ứng dụng khác nhau.
- ACL metadata nên giới hạn retrieval trước khi context được đưa tới model.
- Đồng bộ tăng dần là cần thiết khi tri thức doanh nghiệp thay đổi liên tục.
- Recall và độ trễ cần được đo rõ ràng và diễn giải trong phạm vi workload đã kiểm thử.
Đang thiết kế lớp retrieval RAG cho production?
TitanBases có thể hỗ trợ đánh giá nguồn dữ liệu, kiến trúc retrieval, MongoDB Atlas Vector Search, chiến lược đánh giá, control metadata và lộ trình từ validation pilot đến production.
Thảo luận về kiến trúc Retrieval RAG