Published Oct 9, 2026
AI Orchestration Layer là gì? Triển khai thế nào?
AI orchestration layer giúp doanh nghiệp điều phối model, context, công cụ, policy và observability. Hướng dẫn triển khai từ use case đến production.
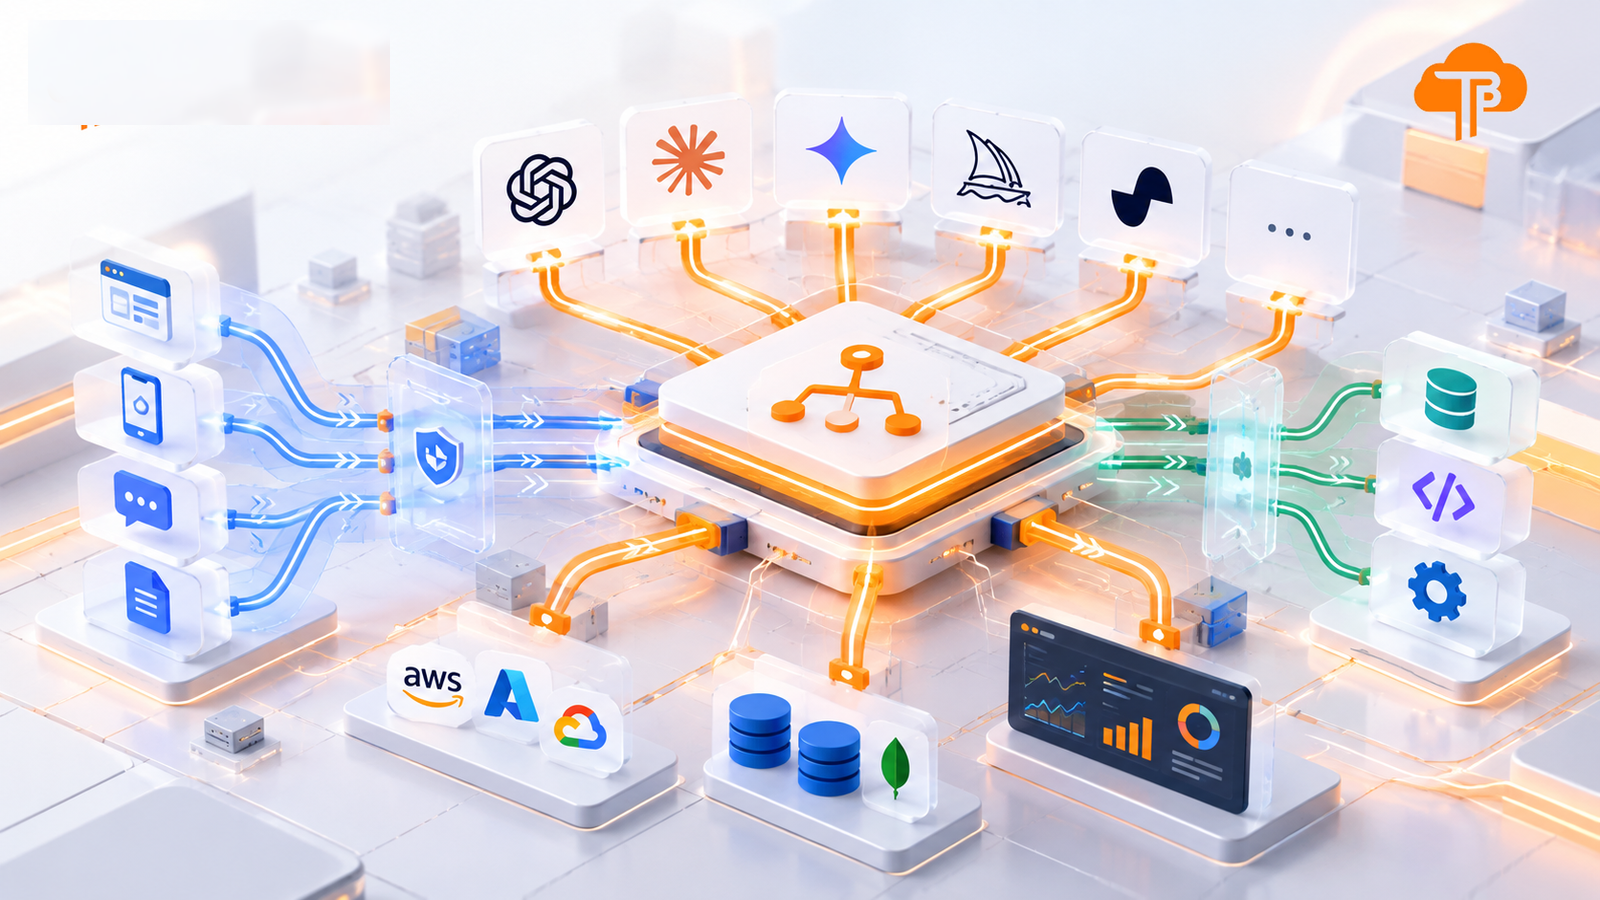
Một team có thể đưa AI vào sản phẩm rất nhanh: chọn model, viết vài prompt, kết nối một endpoint và demo một luồng trả lời khá thuyết phục. Nhưng khi use case bắt đầu chạm vào dữ liệu doanh nghiệp, API nội bộ, nhiều nhóm người dùng và trách nhiệm vận hành, câu hỏi đổi hẳn. Không còn là “model nào trả lời hay hơn?”, mà là “ai được phép làm gì, dựa trên dữ liệu nào, khi nào phải dừng, và nếu sai thì lần lại ở đâu?”. Đó là thời điểm doanh nghiệp cần một AI orchestration layer. Nó không phải là một lớp trang trí đặt trên LLM. Nó là nơi biến một năng lực AI rời rạc thành một hệ thống có đường đi, có state, có policy và có khả năng vận hành. Trong bài này, “orchestration” không được hiểu là tự động hóa mọi thứ. Mục tiêu là làm cho quyền tự động được trao có điều kiện: phù hợp với workload, dữ liệu, mức rủi ro và khả năng kiểm soát của tổ chức.
AI orchestration layer là gì?
AI orchestration layer là lớp phần mềm và policy nằm giữa application layer với các model, nguồn context và công cụ. Nó nhận một yêu cầu nghiệp vụ, xác định cách xử lý phù hợp, chuẩn bị context đúng quyền truy cập, điều phối các bước của workflow, ghi lại những gì đã diễn ra và trả về outcome trong giới hạn đã định. Có thể hình dung nó như control plane của một AI system. Model tạo ra năng lực suy luận hoặc sinh nội dung; orchestration quyết định model đó được dùng cho tác vụ nào, với dữ liệu nào, được gọi những tool nào và outcome nào cần được chấp nhận.
Không phải cứ có Bedrock hoặc Vertex AI là đã có orchestration
Amazon Bedrock, Vertex AI và các nền tảng AI cloud mang lại nhiều capability quan trọng: model access, agent runtime, evaluation, gateway, guardrail hay managed deployment. Ví dụ, Amazon Bedrock AgentCore Gateway cung cấp một entry point an toàn cho agentic traffic, kết nối agents, tools và model targets. Vertex AI Agent Builder có các năng lực xây dựng, scale và govern agents. Đó là những viên gạch tốt để triển khai. Nhưng orchestration của doanh nghiệp không nằm trọn trong tên một dịch vụ. Nó là tập hợp những quyết định riêng của workload: một yêu cầu hỗ trợ khách hàng có được phép tra CRM không; một tác vụ tạo hợp đồng có phải qua human approval không; khi retrieval không đủ evidence thì agent được trả lời hay phải từ chối; fallback sang model khác khi nào; một tenant đã dùng bao nhiêu ngân sách hôm nay. Nền tảng cung cấp primitives. Orchestration layer biến primitives thành một hệ thống có chủ đích, phù hợp với domain và trách nhiệm vận hành của doanh nghiệp.
Vì sao vấn đề này xuất hiện mạnh hơn khi doanh nghiệp đi multi-model?
Trong thực tế, doanh nghiệp không đi multi-model chỉ vì đó là một khái niệm kiến trúc hay. Có team đã thành công với một use case và muốn mở rộng giá trị: tận dụng điểm mạnh khác nhau của nhiều model cho phân tích tài liệu, hỗ trợ khách hàng, reasoning hoặc agent xử lý workflow. Cũng có team phải cân nhắc nhiều model vì chi phí, availability, usage limit hoặc rate limit. Không phải workload nào cũng cần model mạnh nhất. Nếu mọi request đều chạy qua một model frontier, chi phí sẽ tăng nhanh và độ phụ thuộc vận hành dồn vào một provider hoặc một quota. Vì vậy, câu hỏi không phải là “model nào mạnh nhất?”, mà là workload này cần mức năng lực nào, cần truy cập dữ liệu và công cụ nào, và một outcome thành công có chi phí bao nhiêu. Multi-model chỉ có ý nghĩa khi cách ghép năng lực, kiểm soát và economics được thiết kế theo từng bài toán nghiệp vụ.
Kiến trúc tham chiếu: sáu trách nhiệm của orchestration layer
Một implementation không cần bắt đầu bằng mọi thành phần dưới đây. Nhưng khi hệ thống lớn lên, sáu trách nhiệm này nên có chủ sở hữu kỹ thuật và policy rõ ràng.
1. Admission control và routing theo workload
Trước khi gọi model, hệ thống cần xác định loại request, tenant, mức độ nhạy cảm, deadline, ngân sách và quyền gọi tool. Routing có thể chọn model, prompt version, retrieval strategy hoặc human review path. Routing tốt không phải là một bảng “model rẻ, model đắt”; nó được kiểm chứng bằng eval cho workload thật.
2. Context và state là một capability riêng
RAG không chỉ là tìm vài đoạn văn giống câu hỏi. Context cần đi cùng identity, ACL, source, version, freshness và lý do được đưa vào prompt. Với agent có nhiều bước, state cũng không nên nằm trong biến tạm của một process: checkpoint, tool output, approval status và summary cần có nơi lưu bền vững để có thể resume và audit. MongoDB có thể đảm nhiệm phần data foundation này khi workload cần operational data, document context, vector hoặc hybrid retrieval và agent state. Tuy nhiên MongoDB không thay thế policy engine hay workflow orchestrator; nó là nền dữ liệu để orchestration có context và trạng thái tin cậy.
3. Tool gateway và quyền thực thi
Một agent không nên “có quyền gọi API” theo nghĩa rộng. Mỗi tool cần schema input, identity, scope, timeout, idempotency rule, rate limit và cách xử lý lỗi. Các hành động có side effect — gửi email, tạo ticket, thay đổi đơn hàng, chỉnh dữ liệu — nên có ngưỡng approval hoặc cơ chế two-step commit phù hợp. MCP có thể giúp chuẩn hóa cách agent khám phá và gọi tool, nhưng MCP không tự giải quyết authorization hay business policy. Nếu tool boundary không được kiểm soát, orchestration chỉ làm cho một rủi ro cũ chạy nhanh hơn.
4. Workflow, human approval và failure handling
Agentic workflow nên được xem là state machine trước khi được xem là “autonomous”. Xác định rõ node nào gọi model, node nào gọi tool, node nào chờ người duyệt, timeout bao lâu, retry gì và trạng thái nào đi dead-letter. Với tác vụ rủi ro cao, outcome tốt nhất đôi khi là một controlled error có context để người vận hành xử lý tiếp. Human in the loop không phải dấu hiệu thất bại của AI. Nó là một control surface: review các quyết định có tác động cao, xử lý exception và tạo feedback có cấu trúc cho lần triển khai sau.
5. Reliability và policy cho retry
Lớp orchestration cần phân biệt lỗi transient với lỗi cần operator action. Retry vô hạn sau rate limit, quota hoặc lỗi xác thực chỉ tạo thêm tải và che mất nguyên nhân gốc. Các request có side effect cần idempotency key; queue cần backpressure; fallback model chỉ được bật nếu workflow và eval cho phép. Đây là engineering practice của distributed systems, áp dụng vào AI chứ không phải một “tính năng LLM”.
6. Observability, evaluation và economics
Một trace hữu ích cần cho biết request đi qua model nào, dùng context nào, gọi tool gì, mất bao lâu, tiêu thụ bao nhiêu token và outcome cuối cùng là gì. Nhưng telemetry chỉ có giá trị khi nó trả lời được câu hỏi vận hành: workflow nào hay timeout, retrieval nào không đủ evidence, tenant nào làm tăng spend, tool nào tạo vòng lặp, version nào làm chất lượng giảm. Datadog phù hợp khi tổ chức muốn một nền tảng observability SaaS thống nhất cho traces, logs, metrics và agent/LLM telemetry. Grafana với Tempo, Loki và Prometheus hoặc Mimir phù hợp khi team cần một observability stack mở, composable hoặc tự vận hành. Hai hướng không thay thế cho một schema telemetry tốt: trace và metric phải gắn được workflow, model, tenant, tool và outcome.
Vai trò của các AI platform trong kiến trúc orchestration
Một AI platform có thể cung cấp một phần hoặc rất nhiều lớp trong kiến trúc: model hosting, agent runtime, gateway, tool integration, guardrails, evaluation và managed operations. Amazon Bedrock AgentCore Gateway, chẳng hạn, có thể làm secure entry point cho agentic traffic và route model inference qua unified endpoint. Vertex AI Agent Builder cũng cung cấp các công cụ để build, deploy và govern agent. Các capability này làm giảm công sức nền tảng, nhất là ở cloud-native deployment. Nhưng khi enterprise có nhiều ứng dụng, nhiều data domain và nhiều nhà cung cấp model, tổ chức vẫn cần giữ sự rõ ràng về policy và ownership ở cấp kiến trúc của mình. Câu hỏi quan trọng không phải là nền tảng nào có nhiều capability nhất, mà là doanh nghiệp có đang sở hữu cách workload được điều phối theo những giới hạn và outcome mình chịu trách nhiệm hay không. Vì vậy, orchestration layer không cạnh tranh với Bedrock, Vertex AI hay một model provider. Nó xác định cách những capability đó được dùng cùng nhau cho một outcome có trách nhiệm.
Triển khai thế nào mà không xây một “AI platform” quá sớm?
Sai lầm thường gặp là bắt đầu bằng một platform tổng quát khi chưa có workload đủ cụ thể. Con đường an toàn hơn là xây “thin orchestration” quanh một workflow có giá trị và rủi ro đã biết, sau đó chuẩn hóa những phần thực sự lặp lại. Bắt đầu với một outcome có owner, dữ liệu rõ và rủi ro xác định. Định nghĩa identity, context sources, tool allowlist, side effect, approval, SLO và failure mode. Sau đó tập trung routing, context assembly, workflow state, idempotency và audit log cho đúng một use case. Chỉ khi đã có trace end-to-end, eval set, latency baseline và cost attribution, team mới nên thêm model, tool hoặc agent vì một constraint thực sự yêu cầu.
Bốn failure mode nên tránh
Thứ nhất là đặt toàn bộ business policy vào prompt. Prompt có thể biểu đạt ý định, nhưng không phải nơi duy nhất để enforce quyền truy cập, spending limit hay approval. Thứ hai là đưa tool mạnh vào agent trước khi có audit và idempotency. Thứ ba là đo token mà không đo outcome: một workflow ít token nhưng tạo nhiều rework vẫn là workflow đắt. Thứ tư là gọi mọi thứ là multi-agent trong khi không có state transition, ownership và failure boundary rõ ràng. Cũng cần tránh ngộ nhận rằng multi-model luôn tốt hơn. Nhiều model làm tăng bề mặt integration, evaluation và governance. Nếu một model đáp ứng SLO, chi phí và độ tin cậy cho workload hiện tại, sự đơn giản vẫn là một lựa chọn kiến trúc tốt.
Kết luận: orchestration là bước chuẩn bị cho một operating model mới
Trong vài năm tới, một phần công việc từng được gọi chung là “vibe coding” sẽ trở thành năng lực phổ biến: thử model, dựng prototype và tạo feature nhanh. Giá trị của tech team không vì thế mà biến mất. Nó dịch chuyển sang phần khó hơn: biến những năng lực AI rời rạc thành hệ thống doanh nghiệp có thể tin cậy, đo được và cải thiện được. AI Architect chỉ là một cách gọi. Công việc thật là kết nối product, application, cloud, data, security, reliability và economics để AI không chỉ trả lời hay trong demo mà còn làm đúng việc khi đi vào workflow thật. Frontend cần thiết kế experience, consent và human handoff rõ ràng. Backend cần xây API, state, tool boundary và integration có idempotency. Data team cần làm context có quyền truy cập, lineage và freshness. Platform/SRE cần đưa telemetry, SLO, incident response và cost control vào vòng đời vận hành. Người vận hành nghiệp vụ vẫn là người xác định outcome nào đáng tự động, outcome nào bắt buộc phải được duyệt. Không phải doanh nghiệp nào cũng cần một platform lớn ngay bây giờ. Nhưng doanh nghiệp nào đã có nhiều model, nhiều nguồn dữ liệu hoặc nhiều agent đều sẽ gặp cùng một câu hỏi: ai điều phối các capability đó theo cách có trách nhiệm? Bắt đầu từ một workflow cụ thể, giữ boundary rõ ràng và đo outcome trước khi mở rộng. Đó là cách đi thực tế nhất để tiến tới một môi trường nơi con người quản trị agentic AI, thay vì bị kéo theo bởi agentic AI.
Đọc thêm: From AI PoC to Production| Nếu chỉ có model call | Khi có orchestration layer |
|---|---|
| Ứng dụng tự chọn model và prompt tại từng nơi. | Chính sách chọn model, fallback và versioning được tập trung theo workload. |
| Context thường là một đoạn text ghép vào prompt. | Context được retrieval theo quyền, có nguồn, TTL, scope và ngân sách token. |
| Tool call là tích hợp tùy ý trong code. | Tool có identity, schema, allowlist, approval boundary và audit trail. |
| Chi phí là số token cuối tháng. | Chi phí được gắn với tenant, workflow, model, tool và outcome. |